
↔
Nutzen Sie Ihre Datenbasis wieder
Greifen Sie auf Messwerte und Metadaten aus bestehenden ODS-Umgebungen zu, anstatt ein weiteres, paralleles technisches Repository zu erstellen.
PEAK ODS-ADAPTER FÜR APACHE SPARK
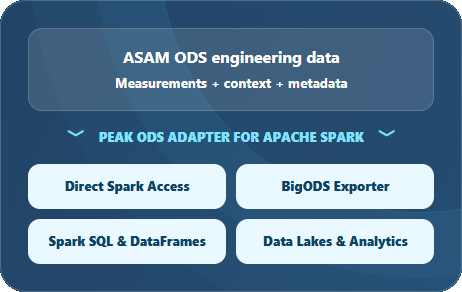
Offene Standars · Spark SQL & DataFrames · Parquet / Avro / JSON · Skalierung nach Bedarf
VON TECHNISCHEN DATEN ZU ANALYTISCHEM MEHRWERT
Technische Daten sind oft sehr aussagekräftig, lassen sich jedoch außerhalb ihrer ursprünglichen Entwicklungsumgebung nur schwer nutzen. Der Peak ODS Adapter für Apache Spark verbindet domänenspezifisches ASAM ODS-Datenmanagement mit bewährten, skalierbaren Datentechnologien.
Greifen Sie auf Messwerte und Metadaten aus bestehenden ODS-Umgebungen zu, anstatt ein weiteres, paralleles technisches Repository zu erstellen.
Nutzen Sie Spark SQL und DataFrames, um die für die jeweilige Analyse benötigten technischen Daten auszuwählen und zu verarbeiten.
Entwickeln Sie sich von lokaler Datenanalyse hin zu verteilter Verarbeitung – mit entsprechend konfigurierten Spark-Ressourcen und -Lizenzen.
Definierte Datenauswahlen in standardkonformen Formaten exportieren, die sich in bestehende Data-Lake- und Analyse-Workflows einfügen.
EINE GRUNDLAGE FÜR TECHNISCHE DATEN · ZWEI INTEGRATIONSWEGE
Wählen Sie das Integrationsmuster, das zu Ihrem Arbeitsaufwand passt. Beide Wege basieren auf denselben, klar definierten ASAM ODS-Messdaten.
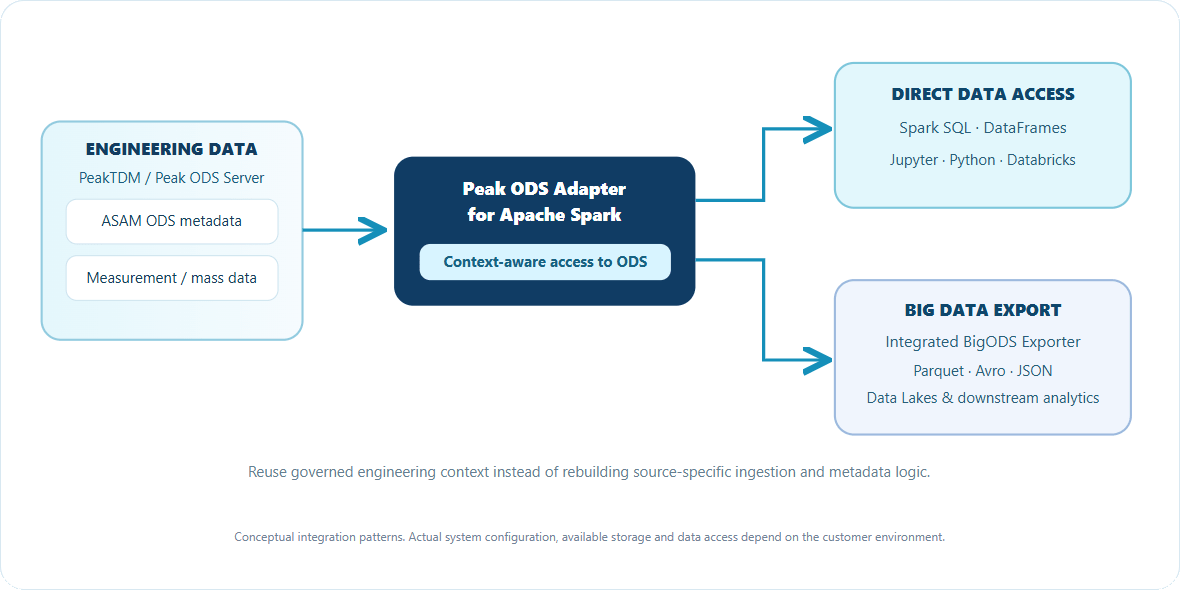
Fragen Sie ODS-Instanzdaten und Messwerte mithilfe von Spark SQL und DataFrames ab. Arbeiten Sie in Python, Jupyter oder anderen Spark-basierten Anwendungen mit ausgewählten Signalen – bei Bedarf unter Nutzung skalierbarer Ressourcen.
Aufbereitung ausgewählter technischer Daten in Form von Dateien, die für die jeweilige Big-Data-Zielumgebung optimiert sind. Der BigODS-Exporter ist Bestandteil des Peak ODS-Adapters für Apache Spark – es handelt sich nicht um eine eigenständige Plattform.
INTEGRIERTE KOMPONENTE · PEAK BIS ODS EXPORTER
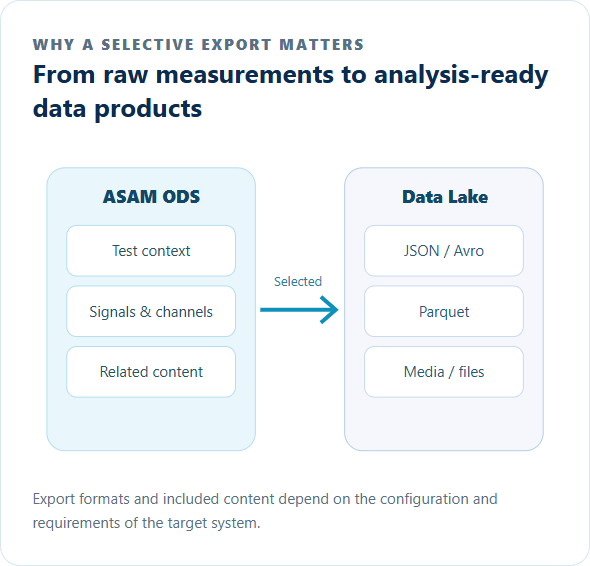
Für unternehmensweite Analysen ist es oft nicht erforderlich, komplette Testkampagnen zu kopieren. Mit dem integrierten „BigODS Exporter“ können Teams gezielt festlegen, welche Daten exportiert werden sollen. Dabei bleibt der technische Kontext erhalten, und Analyseumgebungen werden mit strukturierten Datensätzen versorgt.
Verwenden Sie XML-basierte Exportdefinitionsdateien, um die für eine bestimmte Arbeitslast (Workload) benötigte Teilmenge der ODS-Daten zu definieren.
Integrieren Sie technische Metadaten und Zusammenhänge direkt neben den Messwerten – bei Bedarf ergänzt durch weitere Dateien wie Medien oder Dokumente.
Exportieren Sie Metadaten und Instanzdaten im JSON- oder Avro-Format sowie große Mengen an Messdaten im Parquet-Format – optimal vorbereitet für die nachgelagerte Verarbeitung.
WO TEAMS ES IN DIE PRAXIS UMSETZEN
Analyse ausgewählter Zeitreihenkanäle sowie technischer Metadaten aus bestehenden ASAM-ODS-Repositories mittels SQL, Python und Notebooks.
Verknüpfen Sie eine verlässliche technische Datenbasis mit Spark-basierten Unternehmensanalysen, ohne dabei grundlegende TDM-Funktionalitäten zu duplizieren.
Exportieren Sie zweckbestimmte ODS-Datensätze in offene Big-Data-Formate, um sie für umfassendere Data-Engineering- und Analysezwecke nutzbar zu machen.
ANWENDUNGSBEISPIEL · GLOBALER AUTOMOBILHERSTELLER
Im Rahmen einer globalen Implementierung in der Automobilindustrie stellt der Peak Test Data Manager (PeakTDM) eine auf dem ASAM ODS-Standard basierende, domänenübergreifende Datenbasis für technische Daten bereit. Der Peak ODS-Adapter für Apache Spark verbindet diese Datenbasis mit Databricks und ermöglicht so eine skalierbare unternehmensweite Datenverarbeitung und -analyse.
Skalierbare Unternehmensanalysen, Spark-basierte Datenverarbeitung sowie Möglichkeiten zur Entwicklung von KI-Lösungen.
Wiederverwendbarer Zugriff auf ASAM ODS-Metadaten und Messdaten mittels Spark SQL und DataFrames.
Domänenspezifische Metadatenmodelle, Erfassung von Testdaten, Validierung sowie kontrollierter Zugriff über verschiedene Entwicklungsdisziplinen hinweg.
Anstatt für jede neue Analyseinitiative die Datenaufnahme, das Metadatenmanagement und die Integration von Engineering-Tools jeweils neu aufzubauen, setzt der Kunde auf eine wiederverwendbare Datenbasis mit einer dedizierten Integrationsschicht.
Bei der Integration handelt es sich um eine konkret umgesetzte Kundenarchitektur. Beispiele wie Anomalieerkennung, prädiktives Engineering und KI-Assistenten stellen mögliche zukünftige Anwendungen dar – sie sind keine zugesicherten oder bereits erbrachten Projektergebnisse.
ANTWORTEN VOR DEM START
Nein. Ein direkter Spark-Zugriff kann in Verbindung mit der bestehenden ODS-Dateninfrastruktur genutzt werden. Für Data-Lake-Anwendungsfälle ermöglicht der „BigODS Exporter“ den Export ausgewählter Datensätze, wodurch eine unselektive Datenvervielfältigung vermieden wird. Die konkrete Umsetzung hängt vom Speicherzugriff sowie der Architektur des Kunden ab.
Ja. Der Peak BigODS Exporter ist ein funktionaler Bestandteil des Peak ODS-Adapters für Apache Spark und implementiert den Exportansatz des ASAM ODS Big Data Connectors.
Ja. PeakTDM wurde bereits im Rahmen einer Architektur für einen globalen Automobilkunden mittels des „Peak ODS Adapter for Apache Spark“ in Databricks integriert. Die konkrete Konfiguration in Bezug auf Spark, Netzwerk, Authentifizierung und Bereitstellung hängt vom jeweiligen Projekt ab.
Nein. Der Adapter arbeitet mit ASAM-ODS-Daten. Seine Anwendbarkeit hängt vom verfügbaren ODS-Datenmodell und den Anforderungen Ihrer Tests oder Simulationen ab.
Ja. Die Lösung kann mit lokalen Spark-Ressourcen genutzt und bei Bedarf auf leistungsfähigere Cluster skaliert werden, vorbehaltlich Lizenz- und Infrastrukturvorgaben.
Erzählen Sie uns von Ihrer aktuellen Dateninfrastruktur und Ihren Analyse-Zielen. Wir ermitteln gemeinsam den am besten geeigneten Integrationsweg – sei es durch direkten Spark-Zugriff, konfigurierbare Data-Lake-Exporte oder eine Kombination aus beidem.
Eine einzige Datengrundlage. Vernetzte Engineering-Workflows.
Entdecken Sie die Komponenten und Technologien, die Sie beim Aufbau einer vollständigen, auf Standards basierenden Testdatenumgebung unterstützen.
Peak Test Data Manager
Entdecken Sie die umfassende Plattform für das Engineering-Datenmanagement, die dem Arbeitsumfeld zugrunde liegt.
Peak ODS Server
Messdaten über offene ASAM-ODS-Modelle und standardisierte APIs speichern und abrufen.
Peak Data Transfer Tool
Automatisieren Sie den Import, die Bereinigung und die Metadatenanreicherung aus verschiedenen Testsystemen und Dateiformaten.
Peak Permission Manager
Steuern Sie den Zugriff auf sensible technische Daten mithilfe verwalteter Berechtigungen auf verschiedenen Ebenen.
Mehr zu diesem Thema erfahren
Entdecken Sie weiterführende Artikel, praxisnahe Einblicke und zusätzliche Lösungen, um tiefer in dieses Thema einzutauchen. Erfahren Sie mehr über relevante Technologien, konkrete Anwendungsbeispiele und den Nutzen, den diese für Ihr Unternehmen bieten können.
Peak Test Data Manager trifft auf Databricks
Erfahren Sie, wie ein weltweit agierender Automobilhersteller verlässliche technische Daten mit Analysen und KI im Unternehmensmaßstab verknüpft.
Schlagen Sie die Brücke zwischen ASAM ODS und Big-Data-Lakes:
Erfahren Sie, wie Sie Ihre kontextualisierten ASAM ODS-Daten in Big-Data-Lakes integrieren – ganz ohne den Umbau Ihrer bestehenden Dateninfrastruktur.
Gewinnen Sie mit Apache Spark tiefere Einblicke aus Testdaten.
Erfahren Sie, wie skalierbare Datenverarbeitung und der direkte Zugriff auf ASAM ODS-Messdaten schnellere Analysen, weiterführende Datenanalysen (Advanced Analytics) sowie den Einsatz von KI ermöglichen.
